 Robofauna
설치도, 클라우드도 없이
모든 계산이 내 기기에서 돌아가요. 로봇 파일은 서버로 보내지 않아요.
탭 하나만 열면 내 컴퓨터의 CPU나 GPU로 소형 이족 로봇이 서고 걷는 법을 강화학습(PPO)으로 배워요. 나노에뮤 Sim-to-Real의 시뮬레이션 단계예요. 학습하는 모습을 3D로 바로 보면서요. 파이썬 설치도, 클라우드 GPU도, 로봇공학 전문 지식도 필요 없어요.
rl.robofauna.com · 새 창에서 열려요

ESP32와 서보로 만든 작은 로봇을 걷게 하고 싶은 메이커, 학생, 연구자를 위한 곳이에요. 기존 이족 로봇 프로젝트는 대부분 파이썬과 전용 GPU 환경에서 학습해야 하지만, RL 훈련소는 브라우저만 있으면 돼요.
로봇은 다 만들었어요. 이제 학습 환경을 꾸리지 않고도 걷게 해 보세요.
강화학습이 실제로 무엇을 하는지, 정책이 바뀔 때마다 눈으로 확인해요.
보상과 PPO 설정을 바꿔 이어서 학습하고, 정책끼리 비교해요.
로봇 하나마다 훈련소를 만들고, 훈련소 안에 목표별로 훈련(정책)을 여러 개 둬요.
라이브러리에서 로봇을 골라요. 지금은 14관절 이족 로봇 나노에뮤를 쓸 수 있어요.
5 cm 낙하나 외력에도 넘어지지 않고 서기, 또는 명령에 따라 전진·후진·회전하며 걷기.
정확한 기준인 MuJoCo 물리, 또는 로봇 수천 대를 동시에 돌리는 실험용 WebGPU 물리로 학습해요.
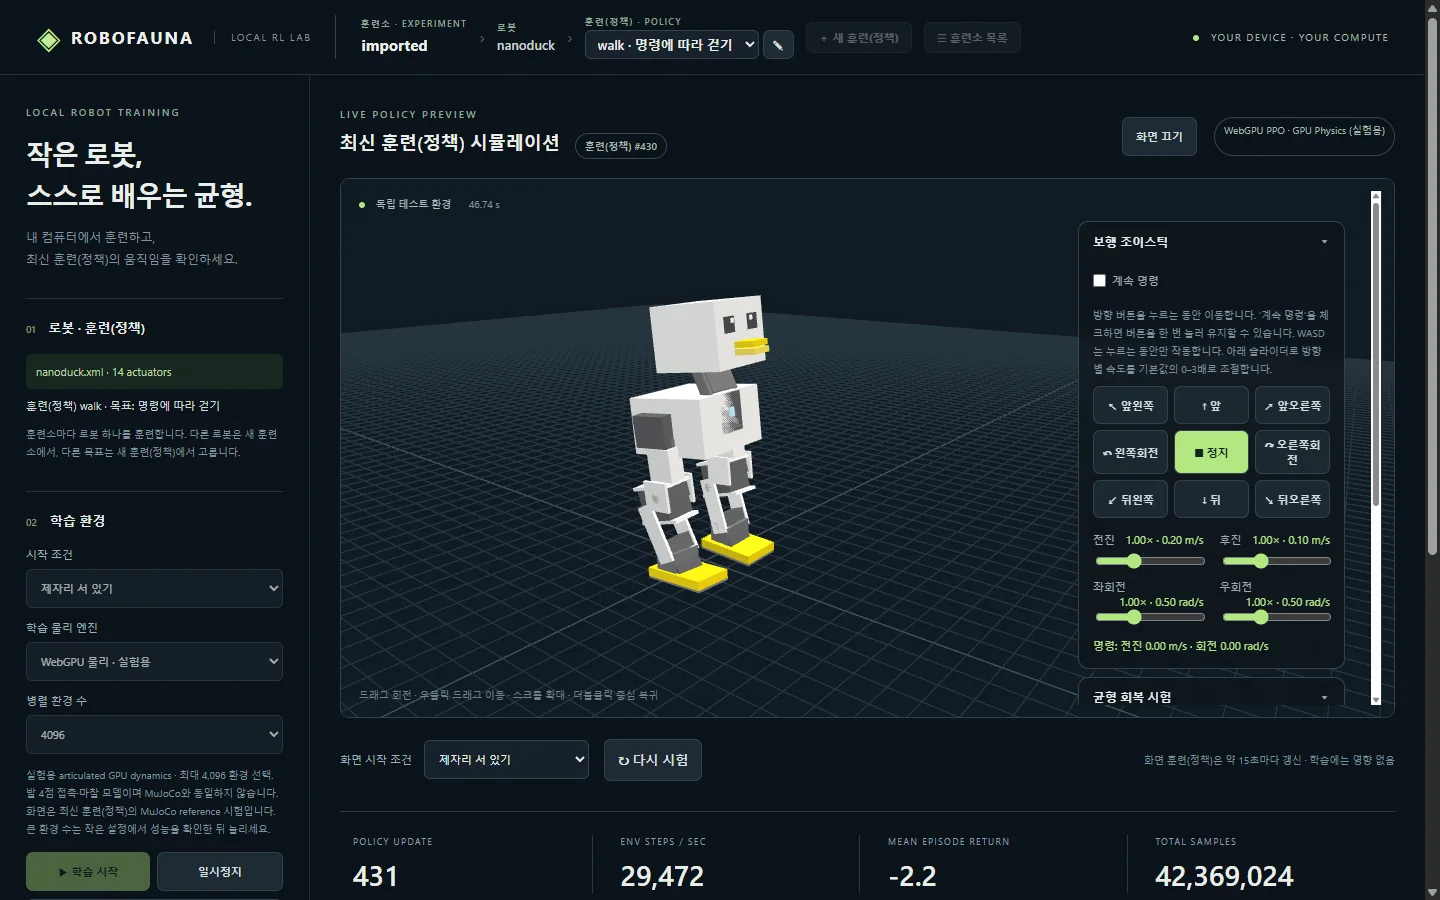
최신 정책이 3D 화면에서 로봇을 움직여요. 8방향 조이스틱이나 WASD로 조종하고, 밀고, 떨어뜨리며 지표를 확인해요.
훈련소는 브라우저에 자동 저장돼요. 파일로 내보내고, 설정을 바꿔 이어서 학습해요.
지금 개발 버전에서 찍은 화면이에요. 로봇 이름과 모델은 출시 전에 바뀔 수 있어요.



TypeScript, MuJoCo WASM, WebGPU(WGSL), TensorFlow.js, Three.js, IndexedDB로 만들었어요.
모든 계산이 내 기기에서 돌아가요. 로봇 파일은 서버로 보내지 않아요.
MuJoCo는 정확한 기준이에요. WebGPU 물리는 실험용이고 초당 약 1.7–2.9만 스텝을 돌려요.
학습이 계속되는 동안 가장 최근 정책이 로봇을 움직여서, 발전하는 모습을 바로 봐요.
보상 곡선에 더해 실제 속도, 명령 오차, 넘어진 횟수, 보행 검사를 보여줘요.
관절마다 영점, 방향, 최소·최대 각도, 시작 자세를 실물 서보에 맞춰요.
로봇마다 정책을 여러 개 두고, 새로고침해도 그대로 복원되며 파일로 내보낼 수 있어요.
학습률 같은 PPO 설정, 보상 항목별 가중치, 보행 명령 범위를 바꿔요.
8방향으로 걷기 명령을 주거나, 밀고 떨어뜨려 균형 회복을 시험해요.
GPU로 나노에뮤 4,096대를 동시에 학습해서 1~2시간 만에 전진·후진·회전 명령을 따라 걷는 정책을 만들었고, 독립 MuJoCo 검사를 통과했어요. 밀렸을 때 버티는 능력은 계속 개선하고 있어요.
WebGPU 물리는 WebGPU를 지원하는 브라우저가 필요해요. MuJoCo 학습은 CPU로 돌아가요.
브라우저에서 학습하고 시험한 다음, 실제 로봇에서 돌리고 함께 나눠요.
걷기는 성공했어요. 다음은 앉기와 일어나기예요.
웹에서 정책을 ESP32용 파일로 내보내 실제 로봇에서 돌려요.
로봇 개, 6족 거미, 휴머노이드까지 내 로봇 XML을 가져오고, 보상을 직접 고치거나 AI와 대화로 설계해요.
로봇 모델과 정책을 올리고, 내려받고, 이어서 학습(리믹스)해요.
고정형 로봇팔의 목표 도달·추종 과제.